Transformer 与概率生成直觉:模型为什么能接着写
正在读取学习记录…
语言模型生成回答时,会根据已有输入计算下一小段文字的候选分布,选择一个 token,再把它接回输入,重复这个过程。token 是模型处理文本时使用的片段;它不一定等于一个汉字或一个单词。Transformer 是现代语言模型常用的一类网络结构,帮助它根据上下文形成这些候选。
我们先用一句短输入看“文本 → 编号 → 数字表示 → 下一个 token”的正常路径,再用手工数字计算注意力和 softmax(把分数变成总和为 1 的权重)。最后讨论为什么模型能解释程序,也可能编出不存在的函数。先读过上一节的向量与点积会更顺;不懂微积分也能跟着数字完成实验。
0. 从接着写,到提出下一步动作
手机输入法会根据前面的文字推荐接下来可能输入的词。语言模型也根据前文计算接下来的一小段文字,再把选出的片段接回前文,继续计算。这个类比帮助理解“逐步生成”;下面再看 Transformer 怎样利用上下文。
在 Agent 中,生成的文字还可以表示动作,例如工具名和参数。模型负责提出动作,程序负责读取参数、检查条件和调用工具:像同事写了一张操作单,再由执行人按单办事。
生成建议之后,程序怎样确认执行结果?
| 对象 | 来自哪里 | 能否证明真实世界动作 |
|---|---|---|
| 模型生成文本 | 下一 token 分布反复解码 | 不能 |
| 结构化工具请求 | 模型输出被解析后的数据 | 不能,仍只是请求 |
| 工具执行结果 | 受控程序调用外部系统 | 只能证明该调用返回了什么 |
| 业务最终状态 | 数据库、查单接口或人工核验 | 用于确认动作是否完成 |
1. 从文本到 token,再到表示
模型通常不直接接收字符串。分词器把文本转成 token ID:token可能是一段词、一部分词、标点或其他编码单元,不能总按一个汉字一个token计算。ID是编号,不是大小有语义的数字;编号100不比编号50“重要一倍”。
嵌入层根据编号取得向量表示,模型还需要位置信息区分先后。“小王帮助小李”和“小李帮助小王”包含相似的词,意思却不同。如果只数每个词出现几次,这两句几乎一样,谁帮助谁的信息就丢了;后面的注意力计算会展示位置之间怎样交换信息。
输入表示经过多层处理后,模型会为每个可能的“下一小段文字”打一个原始分数。这组分数叫 logits,可以先把它当成候选名单上的分数栏。它们还不是概率:可以有负分,也不要求加起来等于1;后面才会把它们转换为概率分布。
2. Transformer 的整体结构
原始 Transformer 是编码器—解码器架构;很多生成语言模型采用解码器式架构,但不能把所有 Transformer 都等同于聊天模型。架构分类
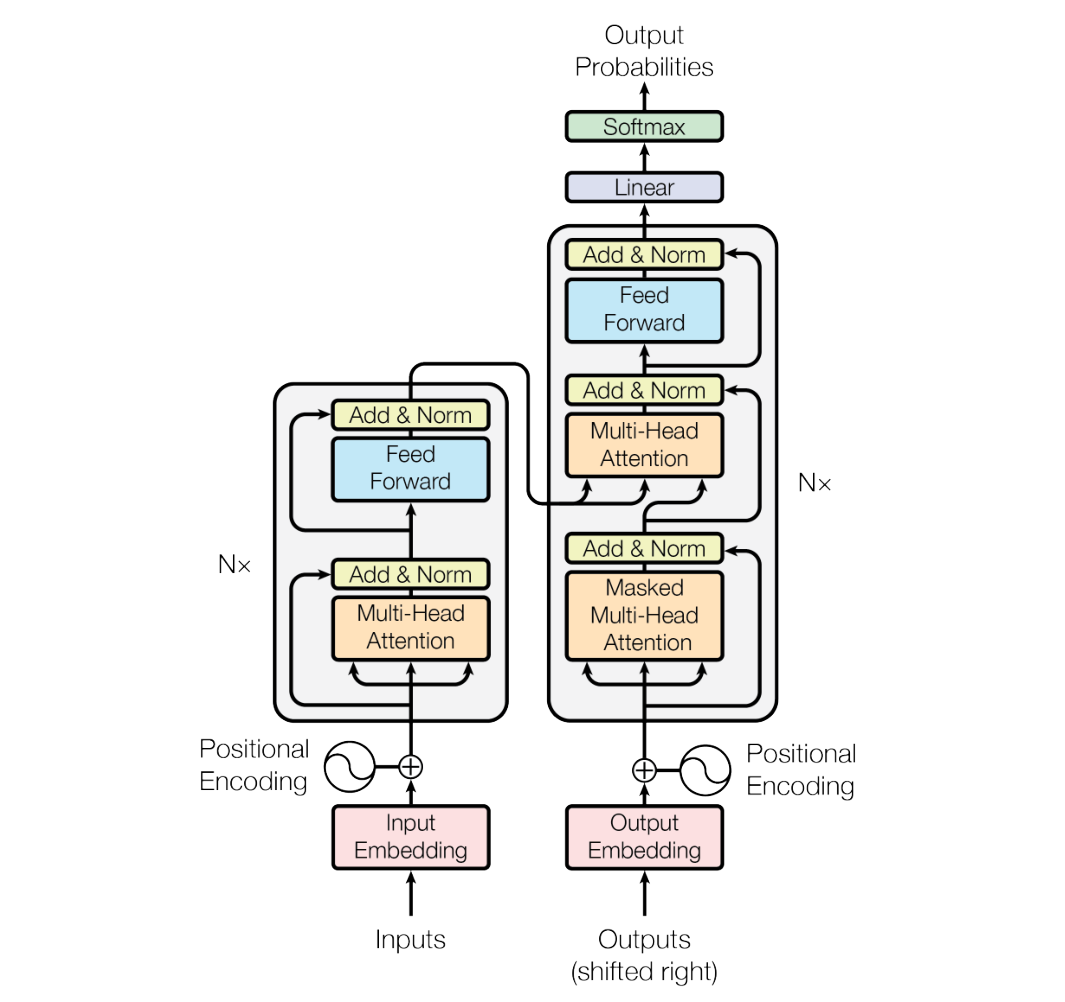
这张图从下往上读。左半边是编码器:把输入文字变成结合上下文的表示;右半边是解码器:结合已有输出和编码器提供的信息,预测下一个 token。中间的跨边连线表示右侧读取左侧的结果。可以先沿着箭头走一遍,再认框里的名称:
| 原图名称 | 中文 | 在这条路径上做什么 |
|---|---|---|
| Input / Output Embedding | 输入 / 输出嵌入 | 把 token 编号转换成向量 |
| Positional Encoding | 位置编码 | 加入文字的先后顺序 |
| Multi-Head Attention | 多头注意力 | 从不同的表示角度混合上下文信息 |
| Masked Multi-Head Attention | 带掩码的多头注意力 | 屏蔽尚不可见的位置 |
| Feed Forward | 前馈网络 | 进一步变换每个位置的表示 |
| Add & Norm | 相加与归一化 | 把原输入与本层结果相加,再调整数值尺度 |
| Linear → Softmax | 线性变换 → Softmax | 算出词表分数,再换算成候选概率 |
框旁的 N× 表示这一组结构重复 N 层。绕过小框的弯线是残差连接:保留原输入,并与这一层算出的结果相加。它像在原笔记上补充信息,而不是每经过一层就把原笔记全扔掉。
先沿一条路径理解:输入表示经过注意力,与上下文中的其他位置交换信息;多层处理后,再得到下一 token 的候选分数。下一节从注意力的三个输入入手,其余组件可以在理解加权计算后回来看。
进一步认识 Transformer 中的其他组件
| 环节 | 这里的理解方式 | 常见误解 |
|---|---|---|
| token与位置表示 | 把编号和顺序变成可计算输入 | token ID数值越大越重要 |
| 注意力 | 按当前表示混合可见位置的信息 | 在外部互联网搜索事实 |
| 前馈网络 | 对每个位置的表示做非线性变换 | 仅把注意力权重输出 |
| 残差与归一化 | 在多层计算中组织表示与数值尺度 | 最终输出前的文字润色 |
| 词表投影 | 得到下一token的候选分数 | 已经执行数据库查询 |
| 解码 | 从分布选下一token并决定何时停 | 模型参数自己执行工具 |
原论文将一次注意力计算写成下面的公式。Q、K、V 分别装着查询、键和值向量;Kᵀ 表示把键矩阵的行列交换,便于批量计算点积;dₖ 是一个键向量包含的坐标数:
Attention(Q, K, V) = softmax(QKᵀ ÷ √dₖ)V
读法是“查询和键比较 → 按维度缩放 → 换算成权重 → 混合对应的值”。下一节用一个查询算具体数字。
3. Q、K、V:比较谁,混合什么
可以先把 Q 理解为“这个位置用什么特征查询”,K理解为“其他位置用什么特征供比较”,V理解为“比较后要混合的信息”。这只是职责类比,不意味着每个向量坐标都有可读含义。
真实模型通常用学到的线性投影从输入表示生成Q、K、V,而不是由人给每个词指定标签。自注意力中的“自”表示查询、键和值来自同一序列的表示;不意味着每个位置只能看自己。
一个查询与每个键做点积,除以键维度的平方根,再用softmax把分数转为权重。每个值向量乘对应权重,再相加,得到新的表示。多头注意力让多个投影子空间各自计算,再组合结果,并不是几个完整Agent互相聊天。
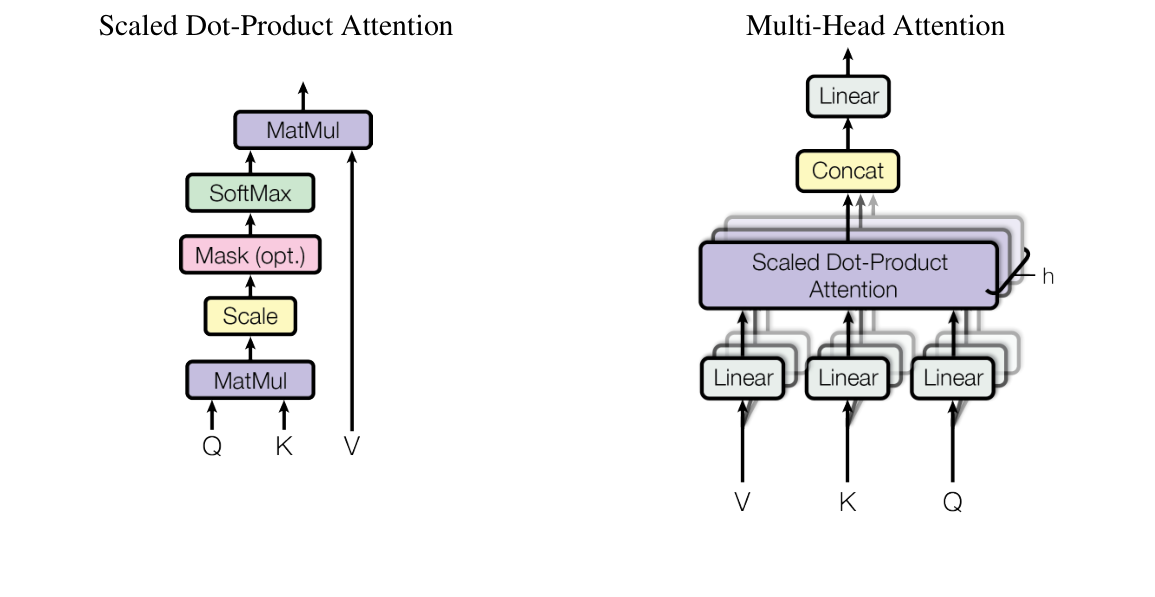
左图仍从下往上读:MatMul 是矩阵乘法,先让 Q 和 K 做批量比较;Scale 是除以 √dₖ;Mask 是屏蔽位置;SoftMax 将可见分数变成权重;顶端 MatMul 再把这些权重用于 V。注意 V 走的是旁边那条线:它提供要混合的内容,不参与前面的比较分数。右图把这条路径并行算多次,再通过 Concat(拼接)合起来,最后做线性变换。
先弄懂 Softmax:怎么把分数变成份额?
假设两种原料的比较分数为 0.7071 和 0。分数只是高低,混合时需要的是比例,例如第一种占多少、第二种占多少,且两份加起来等于 1。Softmax 就做这次换算。
它先把每个分数放进指数函数 exp,再除以这些结果的总和。exp(x) 就是 e 的 x 次方,e 约为 2.718;只需先记住:exp(0) = 1,分数越大,exp 的结果越大,而且结果始终为正。
两项分数的 Softmax:
第一项权重 = exp(s₁) ÷ (exp(s₁) + exp(s₂))
第二项权重 = exp(s₂) ÷ (exp(s₁) + exp(s₂))
很多分数时也一样:每项的 exp 结果除以所有项的 exp 结果之和。实际计算常把所有分数先减去最大的分数,得到同样的比例,同时使数字更容易处理。下面沿箭头算一遍:
4. 手算一次带掩码的注意力
设查询 q=[1,0],三个键分别是 [1,0]、[0,1]、[1,1],值为 [10]、[20]、[999]。这些数字全部手工设置,不来自真实文本。
只允许看前两个位置,第三个被掩码遮住。可见位置的缩放分数为 1/sqrt(2)≈0.7071 和0。softmax 后权重约0.6698、0.3302,第三项为0;混合值为 10×0.6698+20×0.3302≈13.3024。
把“比较”和“取信息”分成两轮:先用 q 与三个 K 比较,决定各占多少份;再用这些份额混合对应的 V。像调一杯饮料,先决定两种原料的比例,再按比例取料。遮挡的第三项没有份额,即使它的数值很大,也不加入这一杯。
| 位置 | 点积分数 | 是否可见 | 权重 | 参与混合的值 |
|---|---|---|---|---|
| 1 | 1 | 是 | 0.6698 | 10 |
| 2 | 0 | 是 | 0.3302 | 20 |
| 3 | 1 | 否 | 0 | 999 |
被遮住的第三项应当完全拿不到权重。仅把它的原始分数改成 0 还不够,因为分数 0 在转换后仍可能拿到一点权重。代码先给可见项分配权重,再给第三项填 0。常见矩阵实现会用很小的特殊值挡住它;如果所有位置都被挡住,还要单独处理,避免产生 NaN(不是有效数字)。
因果掩码用于阻止当前位置看到后续位置的信息。实验中的第三项只是“被屏蔽位置”,没有把它冒充完整训练序列。修改它的值不应改变结果,这正是测试要验证的性质。
如果 softmax 还是陌生,可以把计算拆成四个表格动作:先算可见位置分数 [0.7071, 0];每个分数减去最大值,得到 [0, -0.7071];取指数约为 [1, 0.4931];再分别除以总和 1.4931,得到 [0.6698, 0.3302]。第三个位置根本不进入这组归一化,因此权重为 0。
5. 跑实验,核对手算结果
将 attention.py 和 test_attention.py 按下方代码逐个保存到同一目录:
保存为 attention.py:
"""用手工数字观察注意力混合、Softmax 和温度。"""
import math


def softmax(values, temperature=1):
    # values 是比较分数;temperature 控制分配比例的集中程度。
    if not values or not math.isfinite(temperature) or temperature <= 0:
        raise ValueError('non-empty scores and positive finite temperature required')
    if any(not math.isfinite(x) for x in values):
        raise ValueError('finite scores required')
    # 每项减去同一最大值,比例保持不变,指数计算更稳定。
    maximum = max(values)
    exponentials = [math.exp((x-maximum)/temperature) for x in values]
    # 每项的指数值除以总和,得到加起来为 1 的份额。
    denominator = math.fsum(exponentials)
    return [x/denominator for x in exponentials]


def attend(query, keys, values, allowed):
    # query 是查询 Q;keys 是键 K;values 是值 V;allowed 标记可见位置。
    if not query or not keys or len(keys) != len(values) or len(keys) != len(allowed):
        raise ValueError('query and aligned keys, values, mask required')
    if any(len(k) != len(query) for k in keys) or not values[0] or any(len(v) != len(values[0]) for v in values):
        raise ValueError('inconsistent vector shapes')
    if any(type(flag) is not bool for flag in allowed) or not any(allowed):
        raise ValueError('at least one visible position required')
    if any(not math.isfinite(x) for row in [query, *keys, *values] for x in row):
        raise ValueError('finite coordinates required')
    # allowed 中 True 表示可见;只保留这些位置的编号。
    positions = [i for i, flag in enumerate(allowed) if flag]
    # 查询与每个可见键做点积,再除以维度数的平方根。
    scores = [math.fsum(a*b for a,b in zip(query, keys[i]))/math.sqrt(len(query)) for i in positions]
    # 先把所有位置权重设为 0,再填入可见位置的份额。
    weights = [0.0]*len(keys)
    for i,p in zip(positions, softmax(scores)):
        weights[i] = p
    # 每个值乘自己的权重,再相加得到混合结果。
    output = [math.fsum(weights[i]*values[i][j] for i in range(len(values))) for j in range(len(values[0]))]
    return weights, output


if __name__ == '__main__':
    weights, value = attend([1,0], [[1,0],[0,1],[1,1]], [[10],[20],[999]], [True,True,False])
    print('attention weights:', [round(x,4) for x in weights])
    print('mixed value:', [round(x,4) for x in value])
    for temperature in [0.5,1,2]:
        print(f'logits=[2,1,0], temperature={temperature}:', [round(x,4) for x in softmax([2,1,0],temperature)])
完整代码:test_attention.py
import unittest
from attention import softmax, attend


class AttentionTest(unittest.TestCase):
    def test_probabilities_are_normalized_and_shift_invariant(self):
        # 检查比例总和、大小顺序,以及分数整体加常数后的结果。
        p = softmax([1, 2, 3])
        self.assertAlmostEqual(sum(p), 1)
        self.assertTrue(p[2] > p[1] > p[0])
        for a, b in zip(p, softmax([1001, 1002, 1003])):
            self.assertAlmostEqual(a, b)

    def test_lower_temperature_concentrates_mass(self):
        # 较低温度使最高分获得更大份额。
        self.assertGreater(softmax([0, 1], 0.5)[1], softmax([0, 1], 2)[1])

    def test_invalid_softmax(self):
        # 空分数、非数字值和非正温度应给出明确错误。
        for values, temperature in [([], 1), ([float('nan')], 1), ([1], 0), ([1], -1)]:
            with self.subTest(values=values, temperature=temperature), self.assertRaises(ValueError):
                softmax(values, temperature)

    def test_masked_value_cannot_affect_output(self):
        # 被遮挡位置的值从 999 改为 -999,混合结果保持一致。
        q, keys = [1, 0], [[1, 0], [0, 1], [1, 1]]
        weights, output = attend(q, keys, [[10], [20], [999]], [True, True, False])
        self.assertEqual(weights[2], 0)
        self.assertAlmostEqual(sum(weights), 1)
        self.assertTrue(10 < output[0] < 20)
        self.assertEqual(output, attend(q, keys, [[10], [20], [-999]], [True, True, False])[1])

    def test_all_masked_is_rejected(self):
        # 所有位置都被遮挡时,程序应报告缺少可见位置。
        with self.assertRaises(ValueError):
            attend([1], [[1]], [[10]], [False])

    def test_mismatched_shapes_are_rejected(self):
        # 查询有两个坐标、键只有一个坐标,维度不匹配。
        with self.assertRaises(ValueError):
            attend([1, 0], [[1]], [[10]], [True])


if __name__ == '__main__':
unittest.main(verbosity=2)先在学习目录检查文件。Get-ChildItem 里应同时出现源码和测试;下面命令不会下载模型,也不需要显卡:
pwd
ls
python --versionpython -B -X utf8 attention.py
python -B -X utf8 -m unittest -v test_attention运行 attention.py 后,完整输出如下。前两行对应刚才的注意力计算;后三行对应下一节要比较的温度:
attention weights: [0.6698, 0.3302, 0.0]
mixed value: [13.3024]
logits=[2,1,0], temperature=0.5: [0.8668, 0.1173, 0.0159]
logits=[2,1,0], temperature=1: [0.6652, 0.2447, 0.09]
logits=[2,1,0], temperature=2: [0.5065, 0.3072, 0.1863]
运行测试后,六项检查通过,末尾会显示 Ran 6 tests 和 OK。这六项分别检查分布总和、温度、输入、被遮挡的值、全部遮挡以及输入形状;完整测试就在上方的 test_attention.py 中。
在 attention.py 最后找到以 weights, value = attend(...) 开头的一行,把它替换成下面的多行写法,其他打印语句保持原样:
weights, value = attend(
    [1, 0],                       # 当前查询
    [[1, 0], [0, 1], [1, 1]],     # 三个键 K
    [[10], [20], [-999]],          # 第三个值 V 改成 -999
    [True, True, False],           # 第三个位置仍被遮挡
)
保存后运行 python -X utf8 attention.py,混合值仍为 13.3024。接着把最后的 False 改成 True,第三项有了权重,混合值随之改变。最后恢复原来的值 999 和掩码 False,再运行测试。
其中“改变被遮挡的值,输出保持不变”这项测试,正好检查刚才动手修改时观察到的现象。
跟着 attention.py 看数据怎样流动
先沿这张图追踪一次正常调用,再回到源码看每一步如何实现。左侧计算权重,右侧的值等到最后才加入:
scores 是比较分数,weights 是混合比例,output 是混合后的结果。softmax(values, temperature) 先检查列表非空、温度大于 0、每个值都是有限数。math.isfinite() 会拒绝 NaN 和正负无穷;这些值若混进概率,后续可能整行都变成 NaN,问题却在几层之后才暴露。
attend(query, keys, values, allowed) 的四个输入必须对齐:一个查询向量、若干键向量、数量相同的值向量,以及每个位置一个布尔掩码。假设有三个键,却只给两个掩码,程序无法知道第三个位置是否可见,所以直接拒绝,而不是猜默认值。
positions = [i for i, flag in enumerate(allowed) if flag]
# 对每个可见位置:同坐标相乘求和,再除以维度数的平方根。
scores = [math.fsum(a * b for a, b in zip(query, keys[i])) / math.sqrt(len(query)) for i in positions]
math.fsum() 把每对坐标的乘积加起来,math.sqrt() 计算平方根。enumerate 同时给出位置编号和布尔值;positions 只保留可见下标。计算权重后再放回与全部键等长的列表,这样遮挡位置保持 0,后面的值混合与原位置一一对应。
6. softmax把分数变为分布
对于分数z,softmax对每项取指数,再除以指数总和。为避免大正数指数溢出,可以先减去这组分数的最大值,不改变理论概率:
maximum = max(values)
exponentials = [math.exp((x-maximum)/temperature) for x in values]
denominator = math.fsum(exponentials)
probabilities = [x/denominator for x in exponentials]
注意力权重与词表概率都可能使用softmax,但归一化对象不同:前者对应输入位置,后者对应候选输出token。不能把“某个输入位置权重0.7”解释为“答案正确率70%”。
接下来给三个候选 token 设分数 [2, 1, 0],用同一个 Softmax 函数观察它们怎样分配概率。在完整模型中,这些词表分数由多层网络计算出来;在这个小程序中,我们直接填入这三个数。
7. 温度与选择策略
回看上方输出的后三行:对固定 logits 除以正温度后再 softmax,温度0.5时最高分候选占0.8668,温度2时降到0.5065。低温分布集中,高温分布更平坦。
这些是归一化分数,不是抽样频率。脚本没有进行随机采样。温度0不能代入这段除法,代码会拒绝;某些服务把temperature=0解释成特别的确定性解码约定,需看具体接口。
贪心解码每一步选最高分token;采样按分布抽取。Top-k保留概率最高的k个候选;top-p则从概率最高的候选开始累加,保留累计概率达到p的一组候选。例如概率为0.6、0.3、0.1,p=0.8时保留前两项,因为累计概率达到0.9。它们改变的是从哪些候选里抽取,回答的事实依据仍来自资料和知识。生成策略说明
8. 一次生成为何是一个循环
常见自回归生成把已有token作为条件,得到下一个token,再追加到序列,重复计算直到结束token或长度等停止条件触发。实际系统可使用KV缓存复用部分计算,避免每一步完全从头处理;“逐步生成”不等于“每步都重新执行全部工作”。
训练时可利用已知目标序列和因果掩码并行计算多个位置的训练信号;推理时未知的后续token需要逐步确定。训练会更新参数;普通对话则用已有参数处理新的上下文。
模型生成“调用查询工具”的结构化内容,也只是输出。Agent程序仍需解析、校验、鉴权并执行真实工具,再把结果交回模型。文本中的“已删除”不是文件真的被删除的证据。
9. 练习与实践
课后练习展开习题收起习题
正在读取本地记录…
不调用模型,不执行代码。简答、代码和场景题仅保存答案并展示自查标准,不生成评分、徽章或认证。输入内容不会自动保存,请点击提交;不要填写个人信息或密钥。
选择题 · 下一个token概率代表什么?
模型给某个后续token较高概率,能否据此认定整段回答事实正确?
对应知识点:L0-transformer
简答题 · 两种softmax对应什么?
注意力对三个输入位置得到权重[0.67,0.33,0],词表投影对三个输出token得到概率[0.66,0.25,0.09]。两组数字各自归一化什么?能否将0.67称为答案正确率?
对应知识点:L0-transformer
代码题 · 验证掩码真的遮住信息
使用attention.py,保持前两个值和Q/K不变,将第三个值从999改为-999,第三项始终不可见。写测试验证输出不变、第三项权重为0、权重和为1;再说明全部位置不可见时应怎样处理。
对应知识点:L0-transformer
场景题 · 温度降低后仍然编造函数
模型生成了不存在的库函数。将温度降低后每次都生成同一个错误函数。请解释为什么没有解决问题,给出程序侧验证方案,并说明本篇实验未验证哪些能力。
对应知识点:L0-transformer
再看一个容易手算的变化:把前三个键都改成 [1, 0],三个位置都设为 True,值仍为10、20、999。三个比较分数相同,权重各占三分之一,混合值为 (10+20+999)/3 = 343。运行后对照这个结果,再恢复原例。相同分数怎样分配权重,现在有了一个可以自己算出的答案。
还可以讨论:如果遮挡位置的值改变后输出也改变,是掩码无效,还是计算仍在混合所有值?沿着权重和加权求和逐步定位,而不是先更换模型。
10. 总结与继续阅读
读完后,试着沿这条线向别人解释:输入文字变成 token 和位置表示;可见位置的信息经过注意力混合;后续层给可能的下一 token 打分;解码才把选中的 token 追加到文本里。工具有没有执行,还要看外部程序的记录。
这次手算展示了一次注意力混合。第三个位置被遮住时,把它的值从 999 改为 -999,结果不变;解除遮挡才会改变信息通路。注意力权重0.6698表示这次混合时分给那个位置的比例;事实正确率另用带答案的任务衡量。把自己的 Q/K/V、手算与程序输出一起保存。机制资料可查 Transformer 原论文 v7 与 Hugging Face 生成策略。
开源阅读先看 Hugging Face 的架构分类,再从生成策略页进入解码实现;带着“分数何时产生、温度何时应用、哪里决定停止”这三个问题读。
下一篇:Token 与上下文窗口。
参考资料
- Attention Is All You Need:缩放点积注意力和原始编码器—解码器结构的来源。
- Hugging Face LLM Course:Transformer 架构:编码器、解码器和序列到序列模型的入门分类。
- Hugging Face 生成策略:贪心、采样及候选限制的官方入口;具体参数仍以所用版本为准。
描述会发送给本站维护者,用于修订文章,保存90天。请只填写文章问题,省略个人信息、密钥和内部资料。